
Statistiques
Forfait : FreeVoir ce qu'un fichier contient vraiment, tester une différence, et décrire ce qui distingue un groupe des autres.

Problèmes business
- Avant de modéliser, savoir quelles colonnes sont trouées, constantes ou ne sont que des identifiants.
- Trancher un test A/B à partir des seuls chiffres du rapport de campagne, sans le fichier ligne à ligne.
- Décrire en quelques traits ce qui distingue les clients d'un segment, d'un cluster ou d'un score élevé.
Problèmes académiques
- Enseigner la différence entre significativité et taille d'effet, jauges à l'appui.
- Montrer où se situe une association entre deux variables qualitatives, et pas seulement qu'elle existe.
Méthodes et garanties
- Test t de Welch, sans hypothèse d'égalité des variances ; versions appariées et non paramétriques.
- En comparaison de deux proportions, bascule sur le test exact de Fisher dès qu'un effectif de case est inférieur à 5.
- Croisements lus par résidus standardisés et par courbes cumulées, sans dépendre d'un découpage en classes.
Savoir ce qu'il faut réparer avant d'analyser
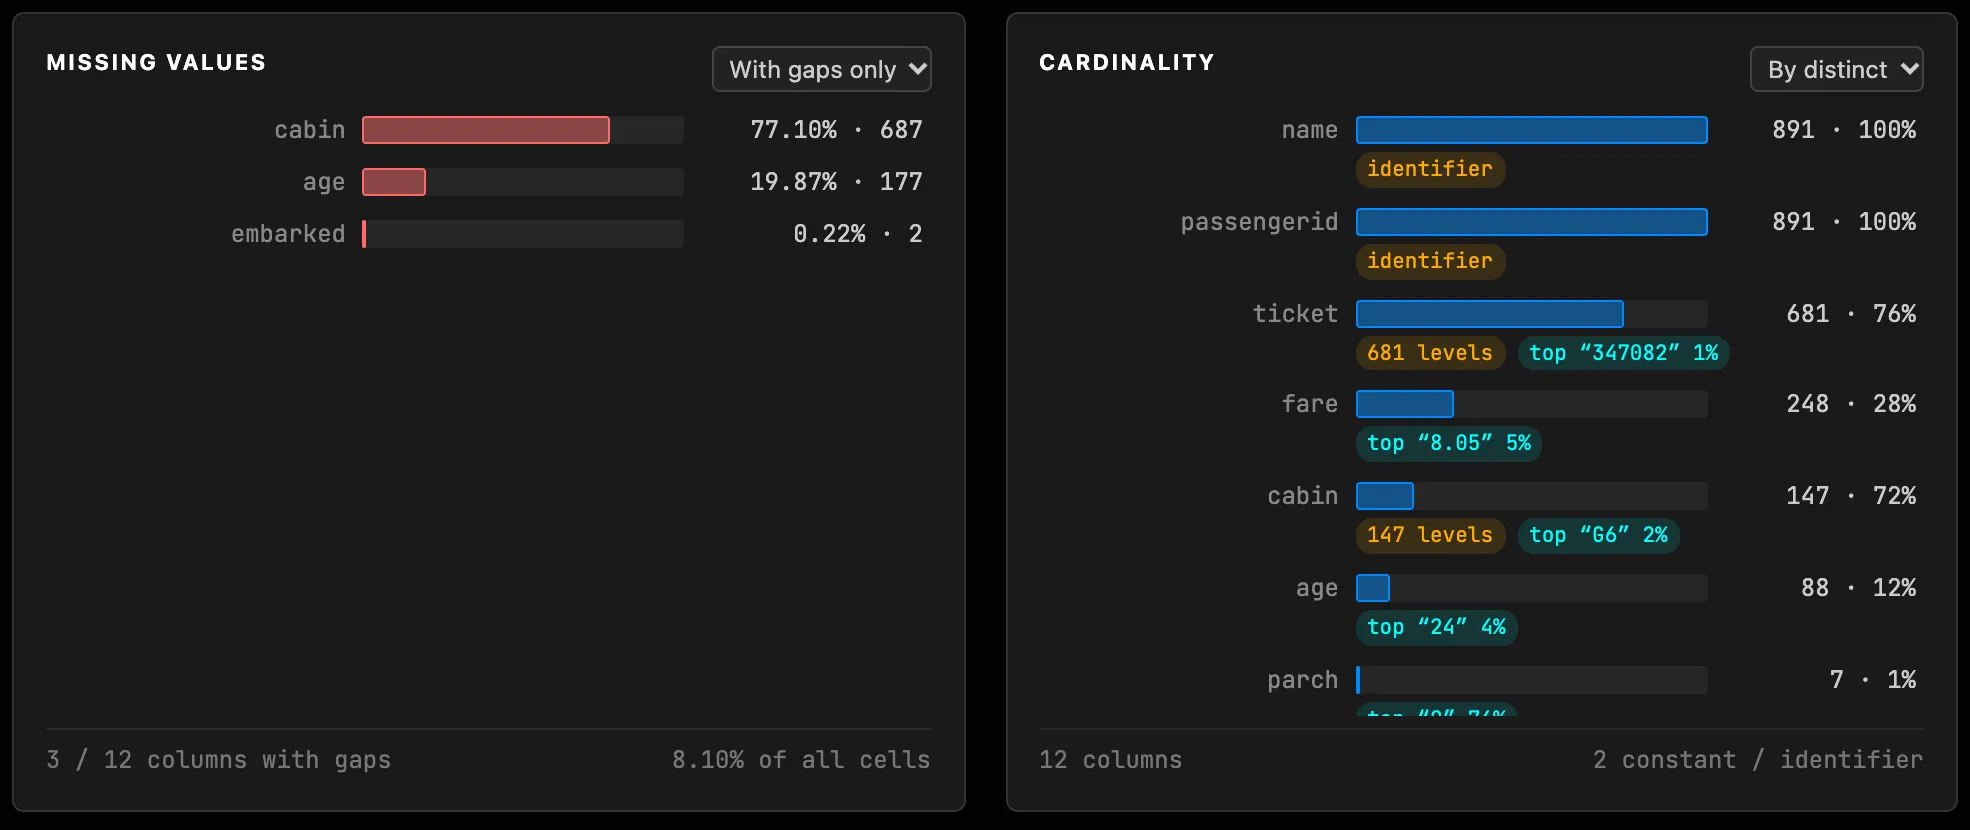
L'onglet Stats se lit de haut en bas, dans l'ordre où l'on découvre un fichier. La première ligne dit ce qui ne va pas. Missing Values classe les colonnes par part de cellules vides et signale d'un badge unreadable → 0 une colonne numérique qui contient du texte : ces valeurs ne sont pas vides, aucune imputation ne les traitera, et elles déplacent la moyenne sans bruit. Cardinality compte les valeurs distinctes et pose un verdict : constant, identifier, binary, ou un nombre de modalités à regrouper avant un encodage.
Lire la forme de chaque variable
Pour les variables numériques : un tableau de dispersion (quartiles, coefficient de variation, trimoyenne…), des boîtes à moustaches, et Normality (QQ), qui compare la variable à une loi normale ou log-normale et dit si un passage au logarithme améliorerait vraiment l'ajustement. La transformation elle-même reste un choix explicite, dans la préparation des données.
Pour les variables catégorielles : la distribution des modalités et Pareto, qui répond à la question qui décide d'un encodage : combien de modalités couvrent 80, 90 ou 95 % des lignes.
Voir où deux variables se répondent
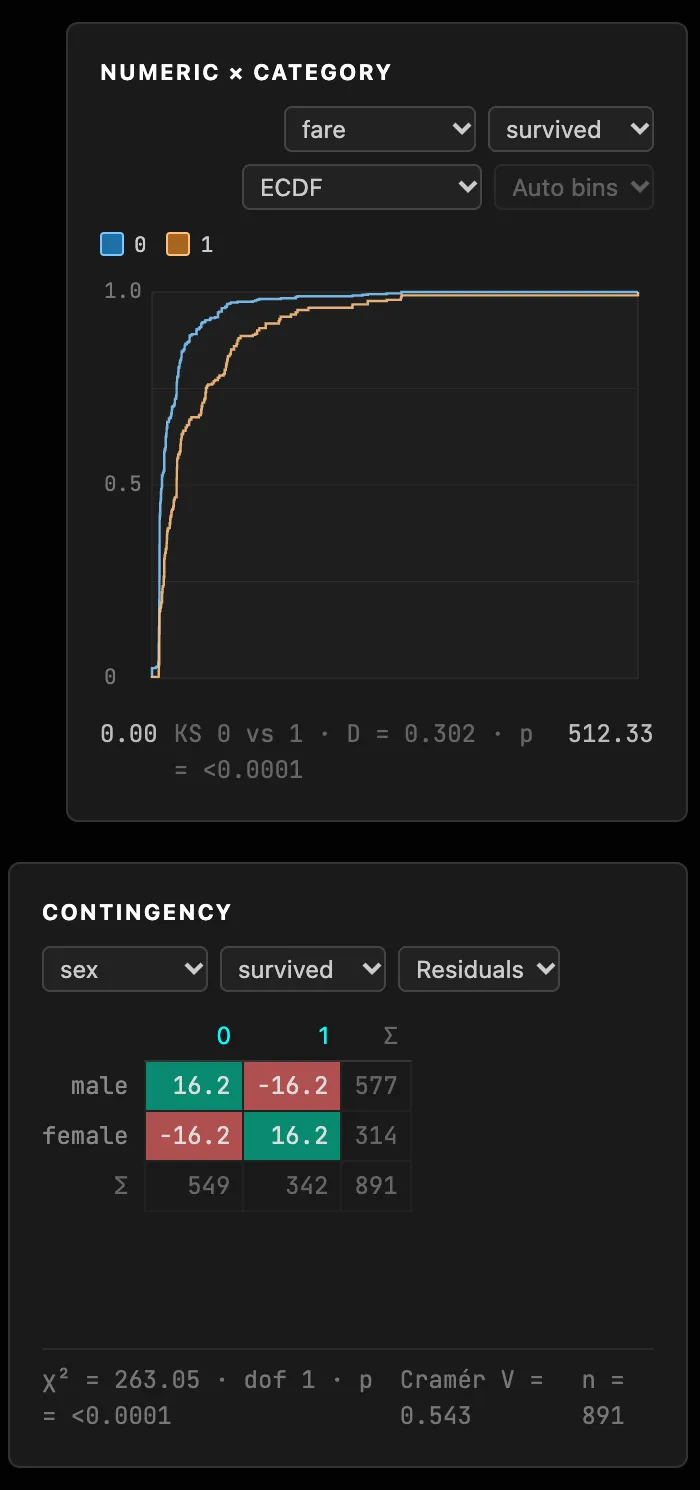
Numeric × Category superpose la distribution d'une variable numérique pour chaque classe d'une variable catégorielle. En mode ECDF, les courbes cumulées ne dépendent d'aucun découpage en barres, et la distance de Kolmogorov-Smirnov mesure leur plus grand écart.
Contingency croise deux variables catégorielles en résidus standardisés : au-delà de 2 en valeur absolue, une case est nettement sur- ou sous-représentée. Le V de Cramér résume l'association en un nombre ; les résidus disent où elle se trouve.
Tester une différence, ou dimensionner un test
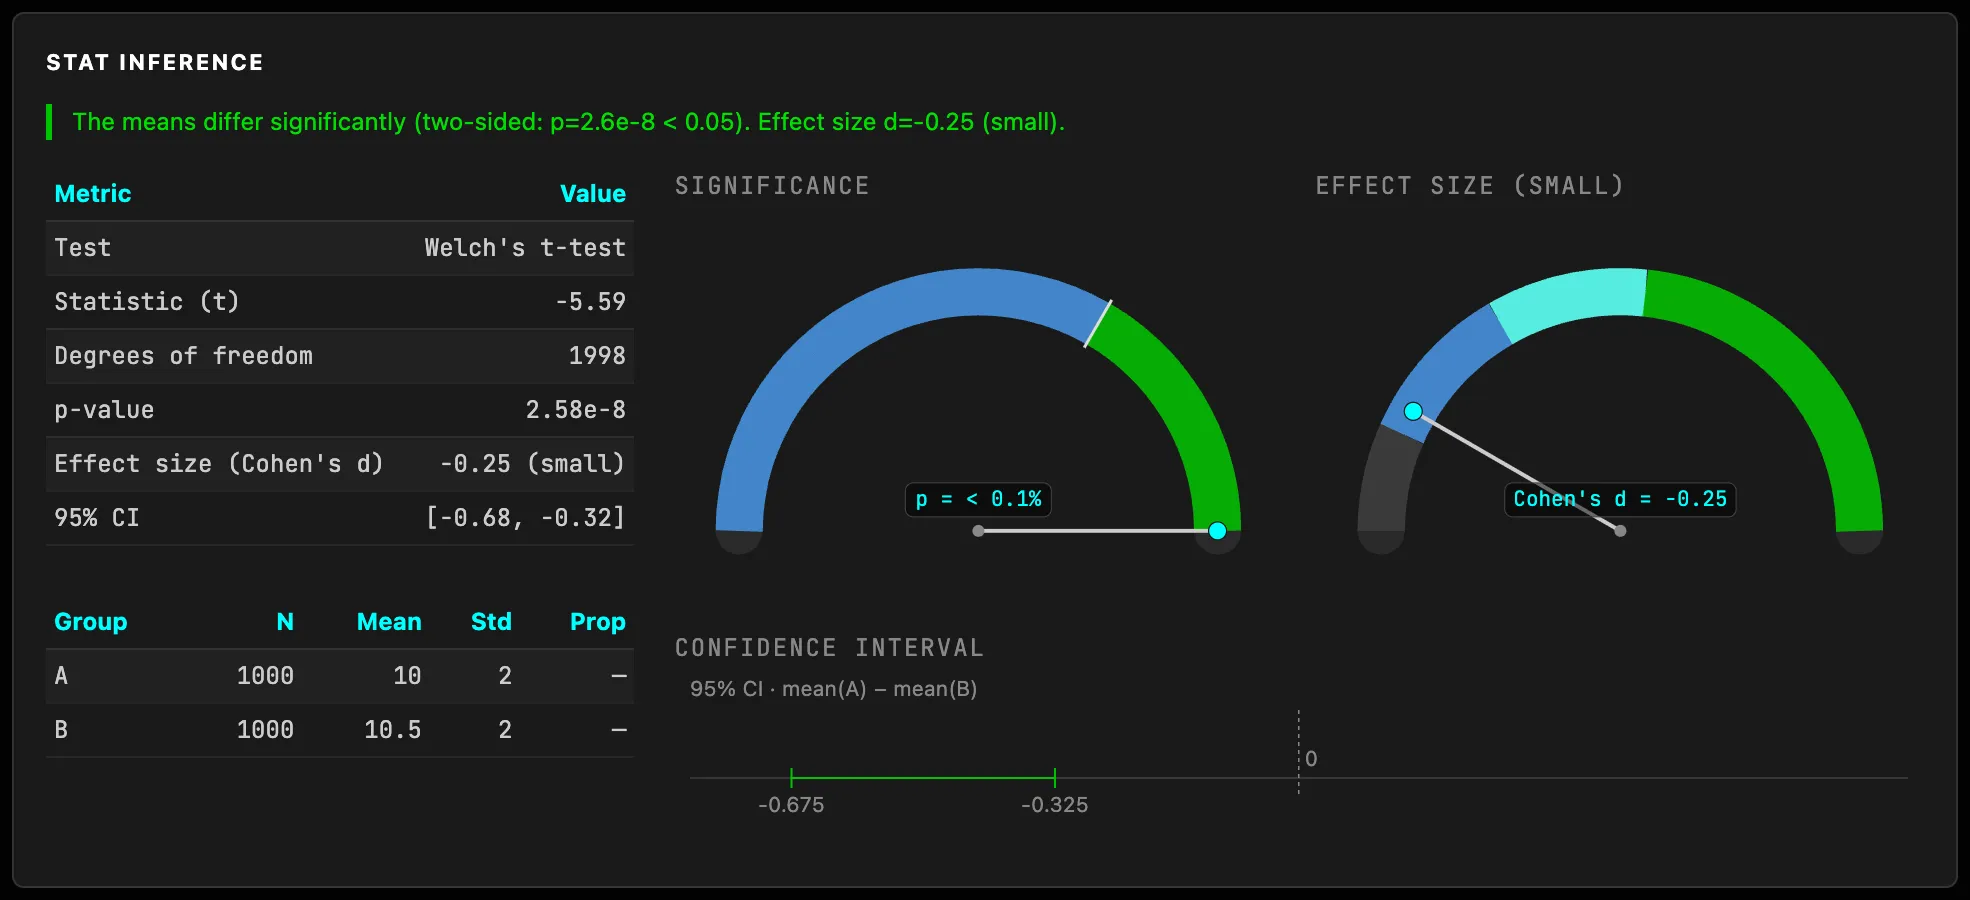
Statistical Inference compare deux moyennes ou deux proportions, sur des groupes indépendants ou sur des paires (avant/après, A et B sur les mêmes unités), en paramétrique ou en non paramétrique. Le résultat donne le verdict, la p-value, la taille d'effet et l'intervalle de confiance, avec des jauges qui séparent ce qui est significatif de ce qui est important. Le mode puissance calcule l'effectif nécessaire, ou la puissance atteinte, avant de lancer une campagne.
Quick Inference fait les mêmes tests sans fichier : on saisit les effectifs, moyennes, taux ou comptes de chaque groupe, comme dans un simulateur de test A/B, et l'on obtient le résultat que donneraient les données ligne à ligne.
Décrire ce qui distingue un groupe
L'onglet Advanced Stats passe à plusieurs variables à la fois. Les tableaux de corrélation mesurent le lien de chaque variable avec une cible, ce qui aide à choisir les variables d'un modèle. Profiling décrit chaque groupe (segment, cible, cluster, quantile de score) par ses valeurs et ses catégories sur- ou sous-représentées, avec lifts et valeur d'information, et en tenant compte d'un groupe témoin quand il y en a un. Use Complement compare chaque groupe au reste de la population plutôt qu'à l'ensemble, ce qui fait ressortir les petits groupes.
Trouver les catégories qui vont ensemble
Les règles d'association cherchent les combinaisons de catégories qui accompagnent une catégorie d'intérêt, filtrées par support, confiance et lift. Un lift élevé signale une règle utile : la catégorie d'intérêt sort nettement plus souvent quand les autres sont réunies.
Essayez-le sur vos données
Tout s’exécute dans votre navigateur : vos données ne le quittent pas.
Ouvrir TétrachoreMis à jour le 6 novembre 2026