
Apprentissage supervisé
Forfait : FreePrédire qui va répondre, et surtout qui répond parce qu'on l'a ciblé.

Problèmes business
- Classer une base clients par probabilité d'achat pour ne contacter que le haut de la liste.
- Ne pas dépenser un budget de relance sur des clients qui auraient acheté de toute façon.
- Repérer les clients qu'une sollicitation fait fuir, avant de les solliciter.
Problèmes académiques
- Enseigner la différence entre un modèle de réponse et un modèle d'uplift sur un A/B test.
- Montrer pourquoi un modèle se juge sur un échantillon de test, et pas sur les lignes qui l'ont ajusté.
Méthodes et garanties
- Valeurs manquantes remplacées par la moyenne d'apprentissage, la même pour le test et l'inférence.
- Uplift par transformation de classe (Jaśkowski et Jaroszewicz, 2012), avec rééquilibrage automatique des bras traité et témoin.
- Coefficient de Qini selon Radcliffe (2007), aux mêmes valeurs que la bibliothèque Python scikit-uplift.
Prédire une réponse, et juger le modèle sur des lignes qu'il n'a pas vues
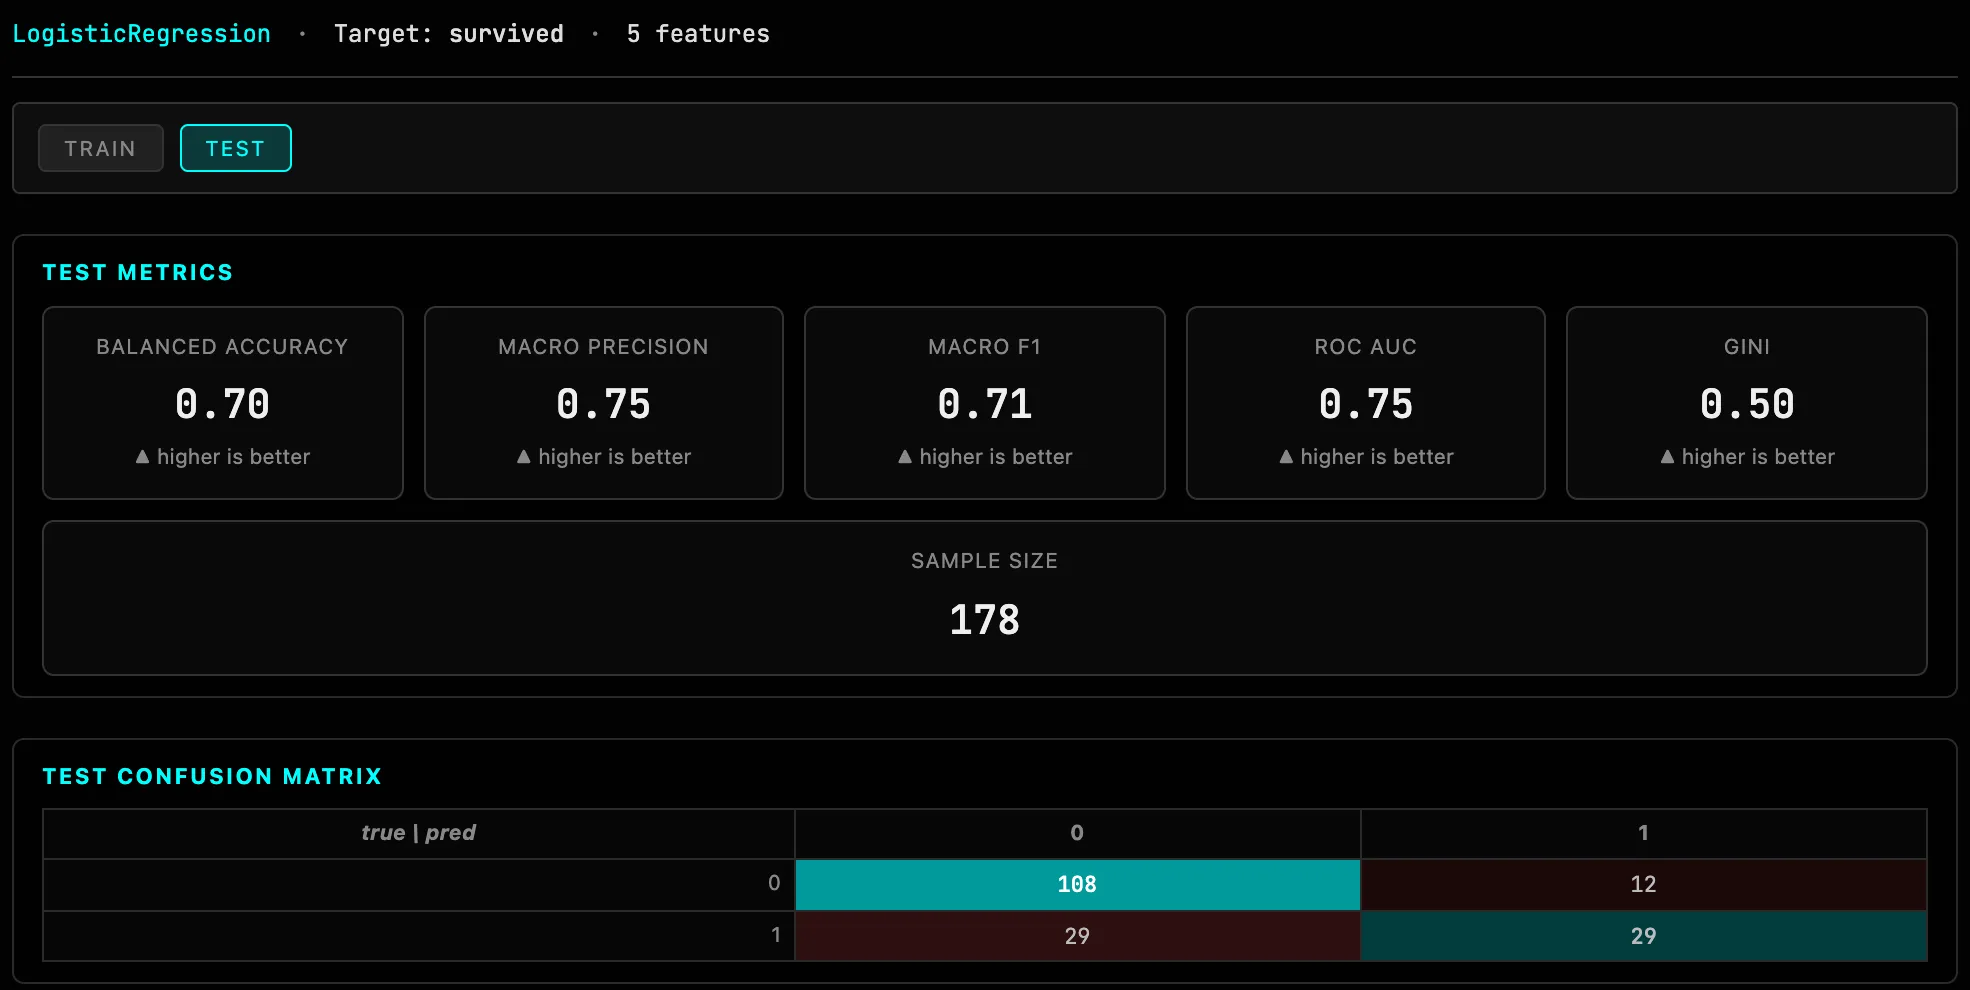
En mode Response, Estimator choisit entre régression linéaire et régression logistique. Les résultats s'affichent dans deux onglets, Train et Test : le second lit l'échantillon mis de côté par la colonne flag_test, ce qui dit comment le modèle se comporte sur des données nouvelles. Régression : R², MAE, RMSE. Classification : exactitude équilibrée, précision et F1 macro, AUC, Gini, et matrice de confusion.
Les valeurs manquantes sont remplacées par la moyenne calculée sur l'apprentissage seul, et la même moyenne sert pour le test : aucune colonne n'est écartée parce qu'elle a des trous.
Savoir qui cibler, et sur quoi repose la prédiction
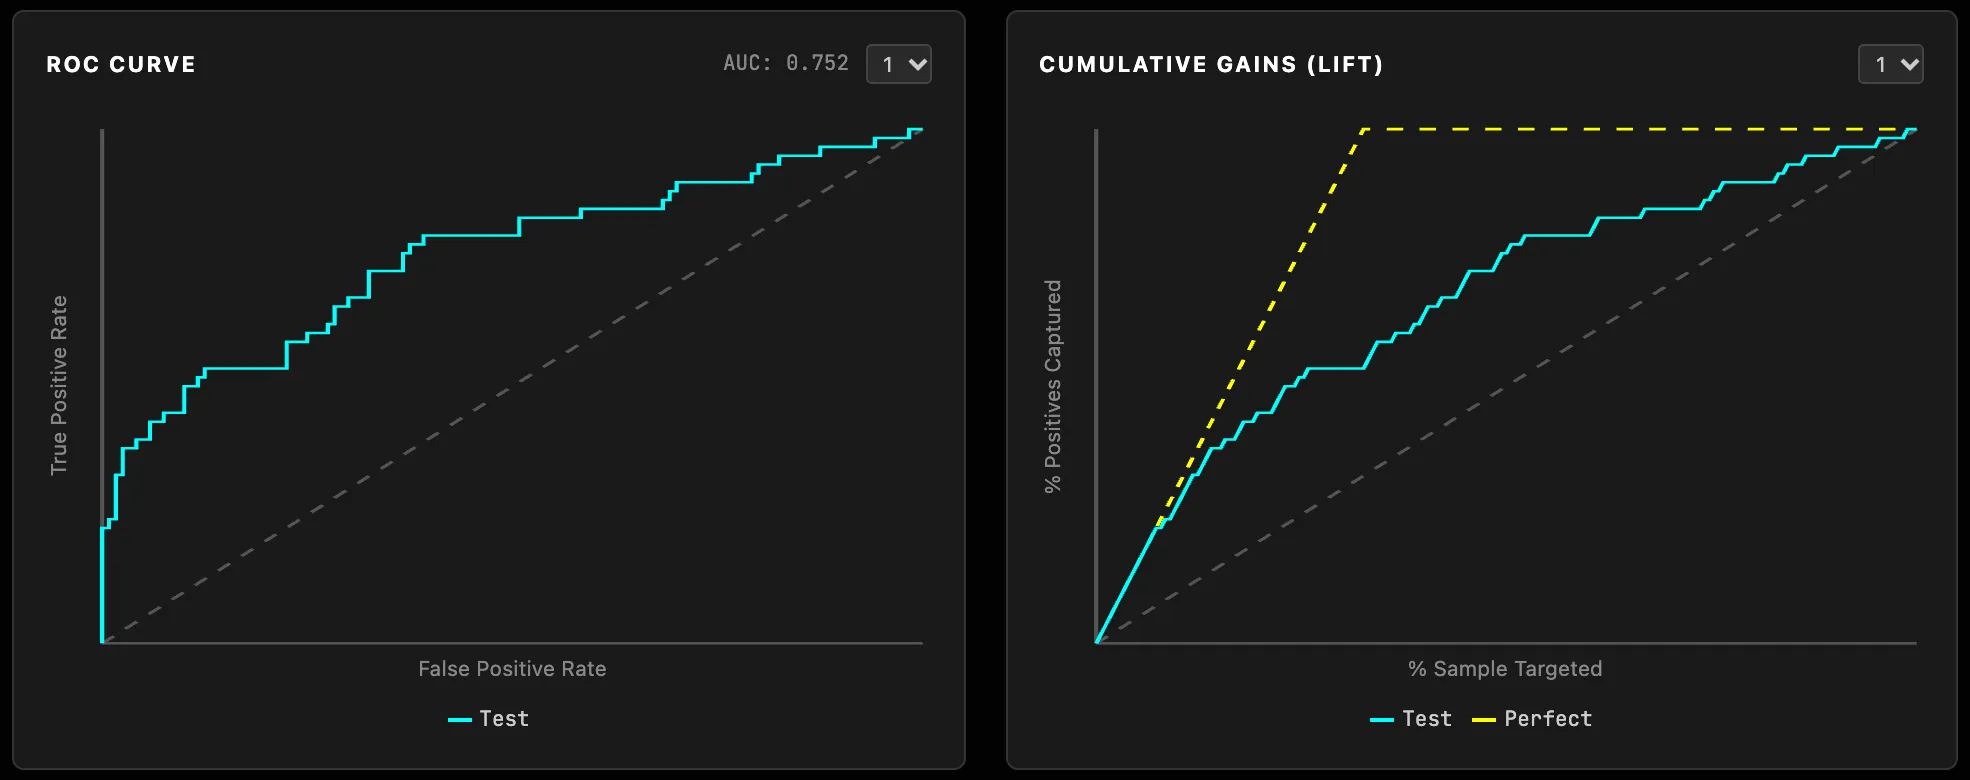
Les coefficients, et pour la régression logistique les odds ratios, montrent le poids de chaque variable. La courbe ROC mesure la capacité du modèle à séparer les classes. La courbe de gains cumulés répond à la question du ciblage : en ne contactant qu'une part de la population, triée par score, quelle part des positifs atteint-on ?
Cibler ceux que l'action fait vraiment changer
Un modèle de réponse dit qui va convertir. Le mode Uplift dit qui convertit parce qu'on l'a traité. La différence compte dès qu'on cible une action : un client qui aurait acheté de toute façon ne rapporte rien à la campagne, et certains réagissent même négativement à une relance. Sur les données d'un A/B test (Treatment, Treated Value), le score prédit pour chaque individu l'écart entre sa probabilité de succès s'il est traité et s'il ne l'est pas, de −1 à 1.
Les bras sont rééquilibrés automatiquement quand ils sont de tailles inégales. Cette lecture suppose que le traitement a été attribué au hasard : sur des données d'observation, aucun réglage ne corrige le biais.
Vérifier qu'un classement d'uplift sert à quelque chose
Uplift Charts découpe les individus par score décroissant et mesure, tranche par tranche, l'uplift réellement observé entre traités et témoins, avec son test et son intervalle de confiance. Cumulative Uplift (Top P%) répond à la question de décision : si je ne cible que les 30 % du haut, quel effet j'obtiens ? Le coefficient de Qini résume la valeur du classement : 1 pour un classement parfait, 0 pour le hasard. BH Correction contrôle le risque de faux positifs quand on lit dix barres à la fois. Les graphiques s'ouvrent sur l'échantillon de test quand il existe, pour ne pas juger le modèle sur les lignes qui l'ont ajusté.
Réutiliser le score
Score Bins découpe le score en quantiles, qui deviennent des groupes à décrire dans le profilage. Inference applique le modèle à un nouveau fichier sans le ré-estimer, et Cluster Predictor ajoute les classes d'un clustering aux variables explicatives. Pour mesurer l'effet d'actions à l'échelle de la campagne plutôt que de l'individu, voir Hy-Performance.
Essayez-le sur vos données
Tout s’exécute dans votre navigateur : vos données ne le quittent pas.
Ouvrir TétrachoreMis à jour le 6 novembre 2026