
Clustering
Forfait : FreeLaisser les données former leurs propres groupes, puis vérifier dans l'espace qu'ils tiennent.

Problèmes business
- Segmenter une base clients sans fixer à l'avance ni le nombre de segments ni leurs frontières.
- Appliquer chaque mois la même segmentation aux nouveaux clients, sans la recalculer.
- Savoir si deux segments sont vraiment distincts, ou seulement séparés par l'algorithme.
Problèmes académiques
- Comparer K-Means et classification ascendante hiérarchique sur les mêmes données, dendrogramme et métriques à l'appui.
- Confronter des groupes découverts sans étiquette à une classification connue.
Méthodes et garanties
- Points isolés écartés dans une classe à part (distance de Mahalanobis) avant le partitionnement.
- Nombre de clusters choisi par le coefficient de silhouette ou par le coude de la courbe d'inertie, dans des bornes fixées.
- Silhouette, Davies-Bouldin, Calinski-Harabasz et Dunn pour juger la partition obtenue.
Trouver des familles sans les avoir définies
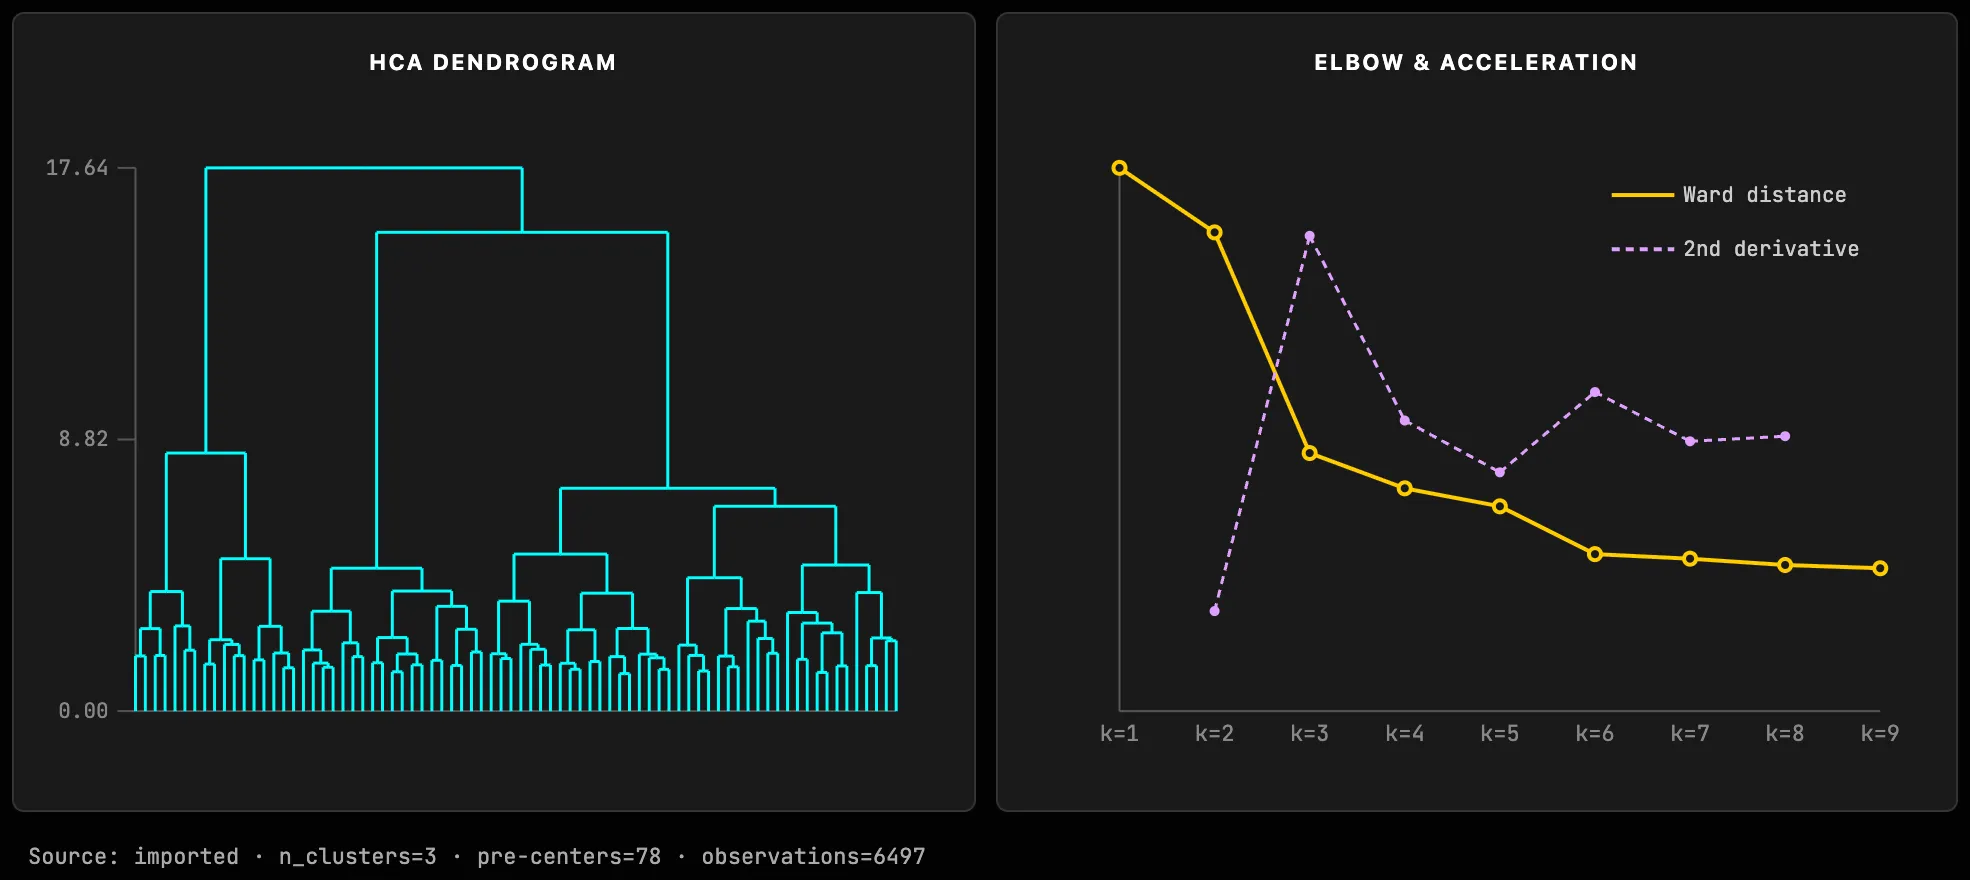
K-Means est un algorithme de partitionnement rapide quand on sait a priori combien de groupes on souhaite obtenir. A contrario, Hybrid permet de segmenter quand on ignore le nombre de clusters optimal. La méthode hybride dérive de la classification mixte : un premier K-Means découpe les données en nombreux centres, puis une classification ascendante hiérarchique de Ward les regroupe, et HCA Auto-Cutoff choisit le nombre de clusters par la silhouette ou par le coude de la courbe d'inertie inter-classes. Un dernier K-Means (Post-KMeans) réaffecte les points de frontière au cluster le plus proche, et Merging Threshold % fusionne les groupes trop petits.
Filter Outliers écarte au départ les points isolés dans une classe à part, pour qu'ils ne déforment pas les autres.
Juger la segmentation avant de s'en servir
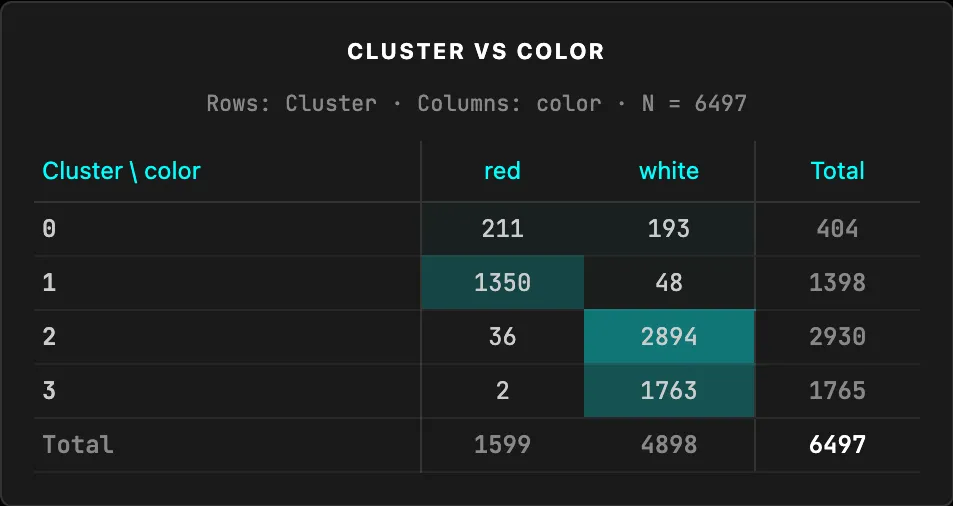
Quatre métriques chiffrent la partition : silhouette, Davies-Bouldin, Calinski-Harabasz et Dunn. Suivent la taille de chaque cluster, la distribution de chaque variable par cluster, et les tableaux croisés avec les variables d'intérêt (segment, cible, groupe traité). C'est là qu'on vérifie si des groupes découverts sans étiquette recoupent une classification connue.
Voir si les groupes tiennent dans l'espace
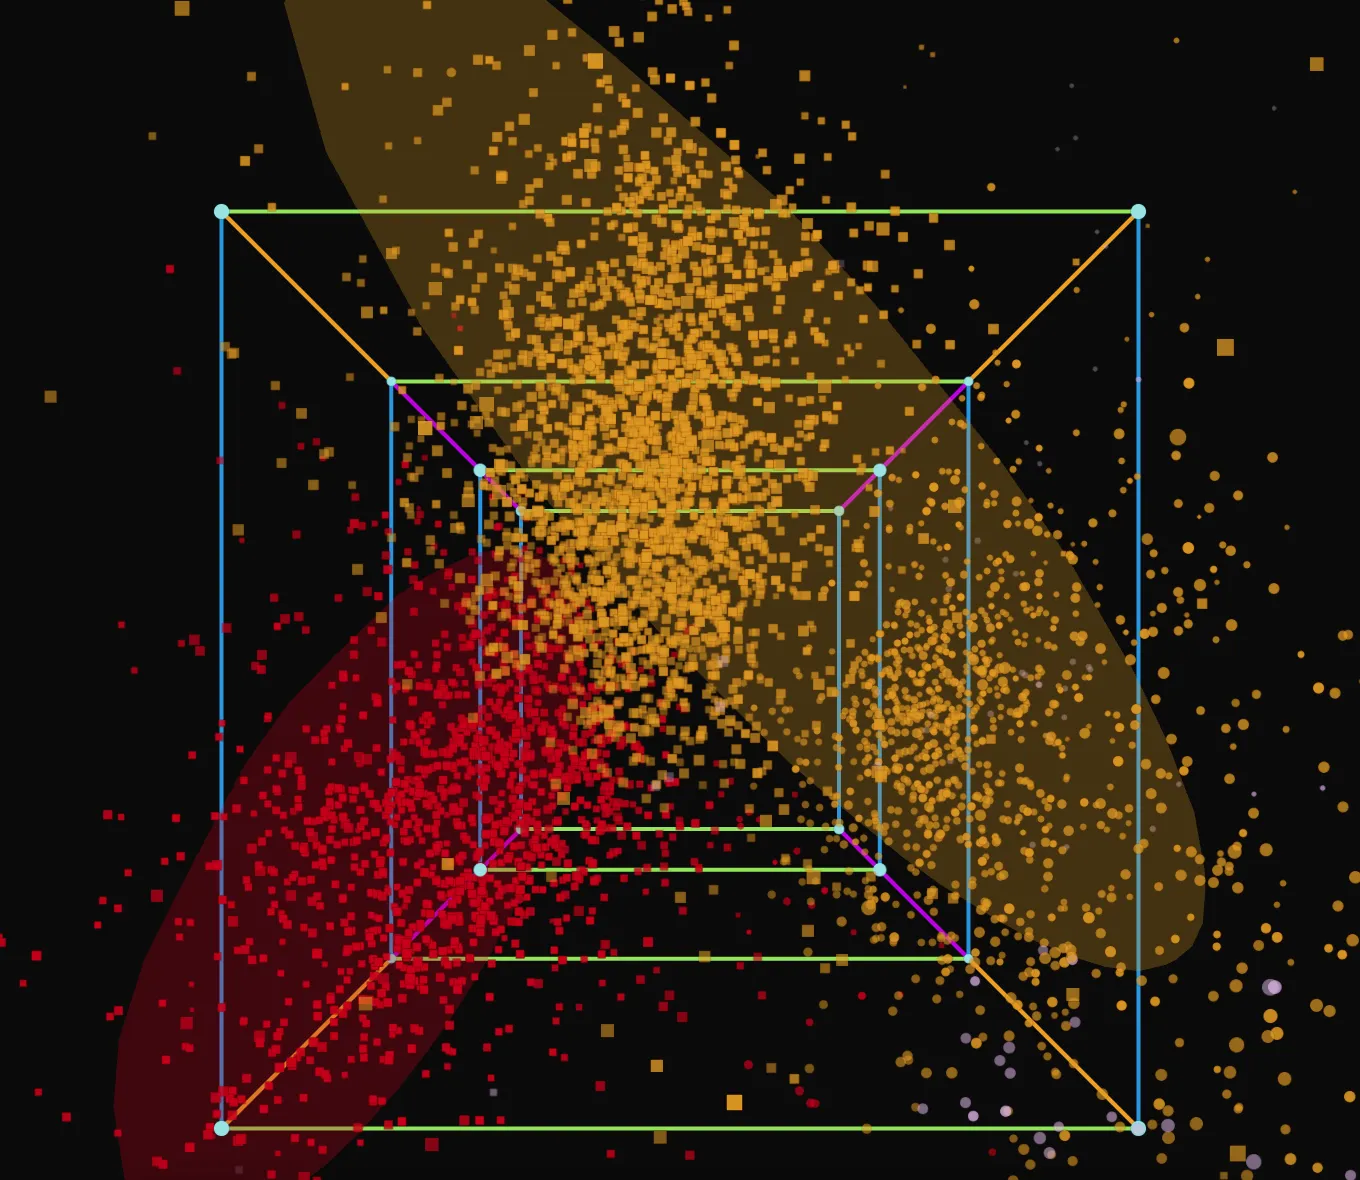
Les clusters se colorent dans la scène 3D, et Show Ellipsoids dessine autour de chacun une enveloppe de covariance, réglable en écarts-types (k·σ). Deux enveloppes qui se chevauchent signalent des clusters ambigus. En faisant tourner la scène, on vérifie que le chevauchement est réel et pas un effet de la projection.
Choisir ce que l'on regroupe
Le clustering porte sur les données importées, sur les points de la scène, sur les individus ou les variables d'une analyse factorielle, ou sur les répondants d'Hy-Personality. Standardize met les variables à la même échelle. Partition rattache chaque point au point de référence le plus proche, et Reference as Center part de ces points de référence comme centres initiaux.
Une fois les clusters formés, le profilage décrit ce qui caractérise chacun.
Appliquer la segmentation à de nouvelles données
Inference applique un modèle de clustering déjà entraîné à de nouvelles lignes, sans le recalculer : les nouveaux clients rejoignent les segments existants.
Essayez-le sur vos données
Tout s’exécute dans votre navigateur : vos données ne le quittent pas.
Ouvrir TétrachoreMis à jour le 7 novembre 2026