
Données
Forfait : FreeCharger un fichier, dire à chaque colonne ce qu'elle est, et le préparer pour l'analyse sans fausser les tests.

Problèmes business
- Un export client arrive avec des cases vides, des montants extrêmes et des catégories qui ne comptent que trois personnes.
- Le modèle calibré le mois dernier doit s'appliquer au fichier de ce mois, avec exactement la même préparation.
- Un gros fichier ralentit tout, alors qu'un échantillon suffirait pour explorer.
Problèmes académiques
- Montrer sur un cas concret pourquoi une imputation ou un plafonnement s'estime sur l'échantillon d'apprentissage seul.
- Disposer de jeux classiques, dont le Titanic en versions numérique, catégorielle et mixte, pour enseigner ACP, ACM et AFDM.
Méthodes et garanties
- Les paramètres de chaque transformation sont estimés sur les lignes d'apprentissage, puis appliqués à toutes les lignes.
- Les étapes s'enchaînent dans un ordre fixe, du typage des colonnes à l'encodage disjonctif.
- Chaque transformation s'annule séparément, et l'ensemble d'un seul geste.
Commencer sans fichier
Le panneau Dataset de l'onglet Workspace charge des jeux synthétiques prêts à l'emploi : des nuages aléatoires à 5 ou 12 variables, le Titanic en trois versions (Titanic Data, Titanic Categ. Data pour l'ACM, Titanic Mixed Data pour l'AFDM), un jeu marketing pour le MMM, deux jeux de survie et deux jeux Hy-Performance. Chacun sert de terrain d'essai au module correspondant avant d'y mettre ses propres données.
Les scénarios guidés vont plus loin : ils chargent un jeu, posent les rôles et lancent l'analyse en un clic.
Importer son fichier et dire à chaque colonne ce qu'elle est
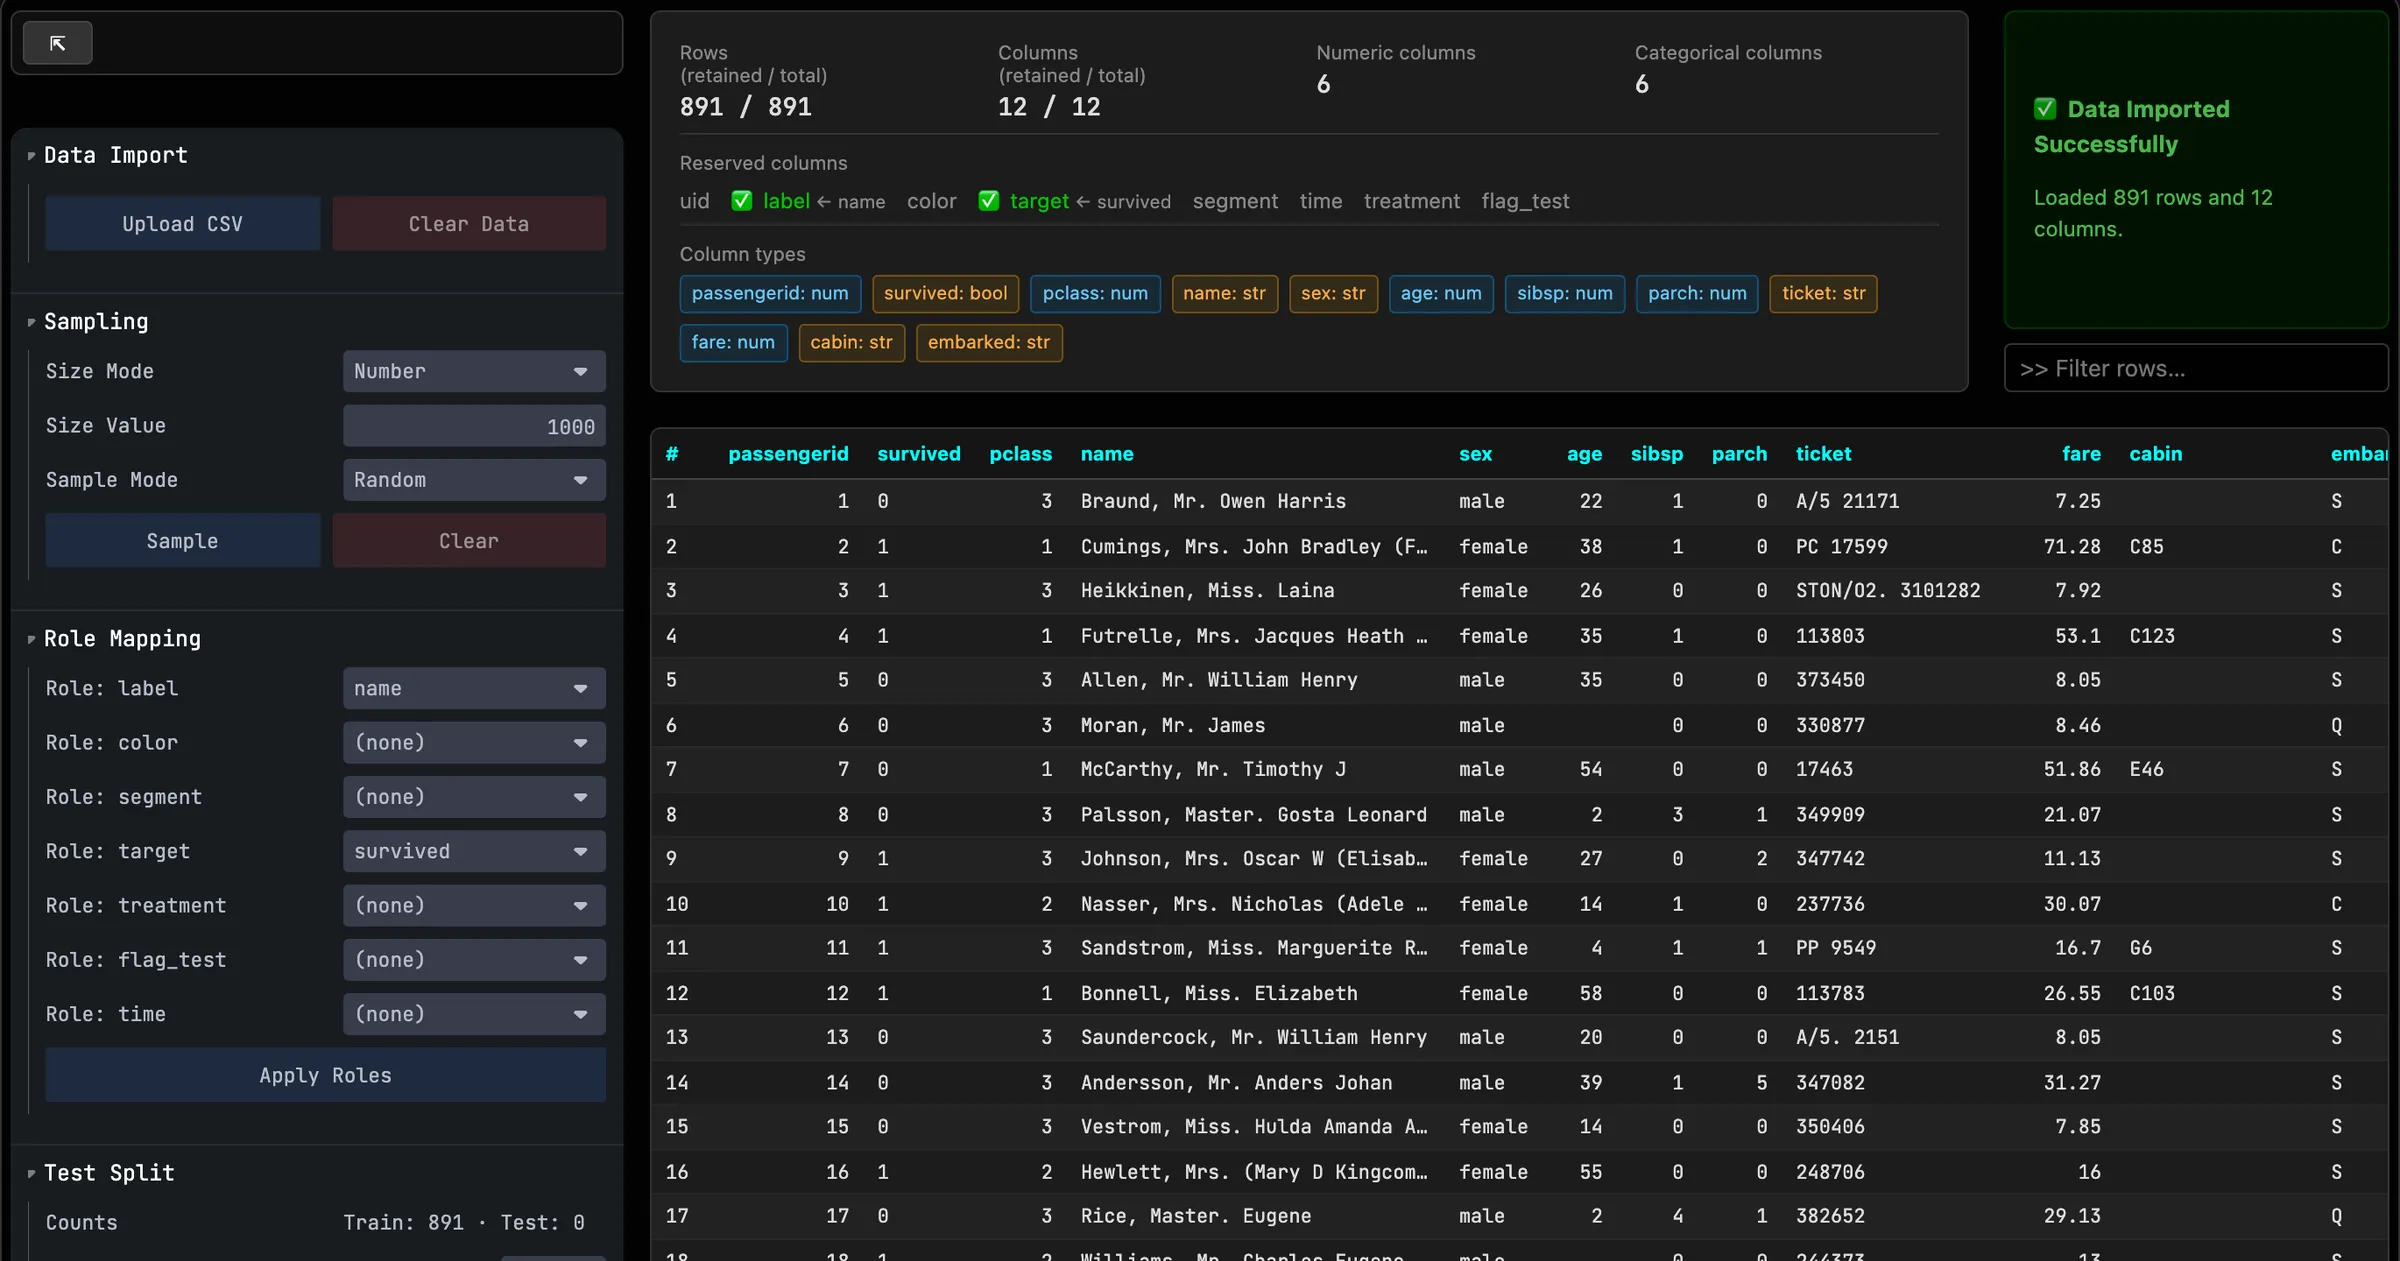
Upload CSV accepte un fichier UTF-8 avec une ligne d'en-tête, séparé par des virgules, points-virgules, tabulations ou barres verticales. Les colonnes nommées x, y, z, w, v5… se placent d'elles-mêmes sur les axes de la scène ; sinon, les colonnes numériques s'y rangent dans l'ordre du fichier.
Role Mapping désigne les colonnes qui jouent un rôle : le nom affiché à côté du point (label), la couleur (color), le groupe à comparer (segment), la variable à expliquer (target), le groupe traité face au témoin (treatment), le découpage apprentissage/test (flag_test). Une fois Apply Roles cliqué, l'en-tête de l'onglet récapitule les lignes et colonnes retenues, les rôles attribués et le type détecté de chaque colonne : numérique, catégorielle ou booléenne.
Travailler sur un échantillon, réserver un jeu de test
Sampling réduit un gros fichier à un nombre de lignes ou à une proportion, tirées au hasard (Random) ou prises en tête (Head) ou en fin (Tail) de fichier, ce qui compte pour des données chronologiques. Clear rétablit le fichier complet.
Si le fichier ne porte pas de colonne flag_test, Random Split la crée selon la part choisie dans Test Size, et le moniteur Counts affiche la répartition obtenue. Les modèles supervisés s'entraînent alors sur une partie et se jugent sur l'autre.
Préparer les données sans fausser le test
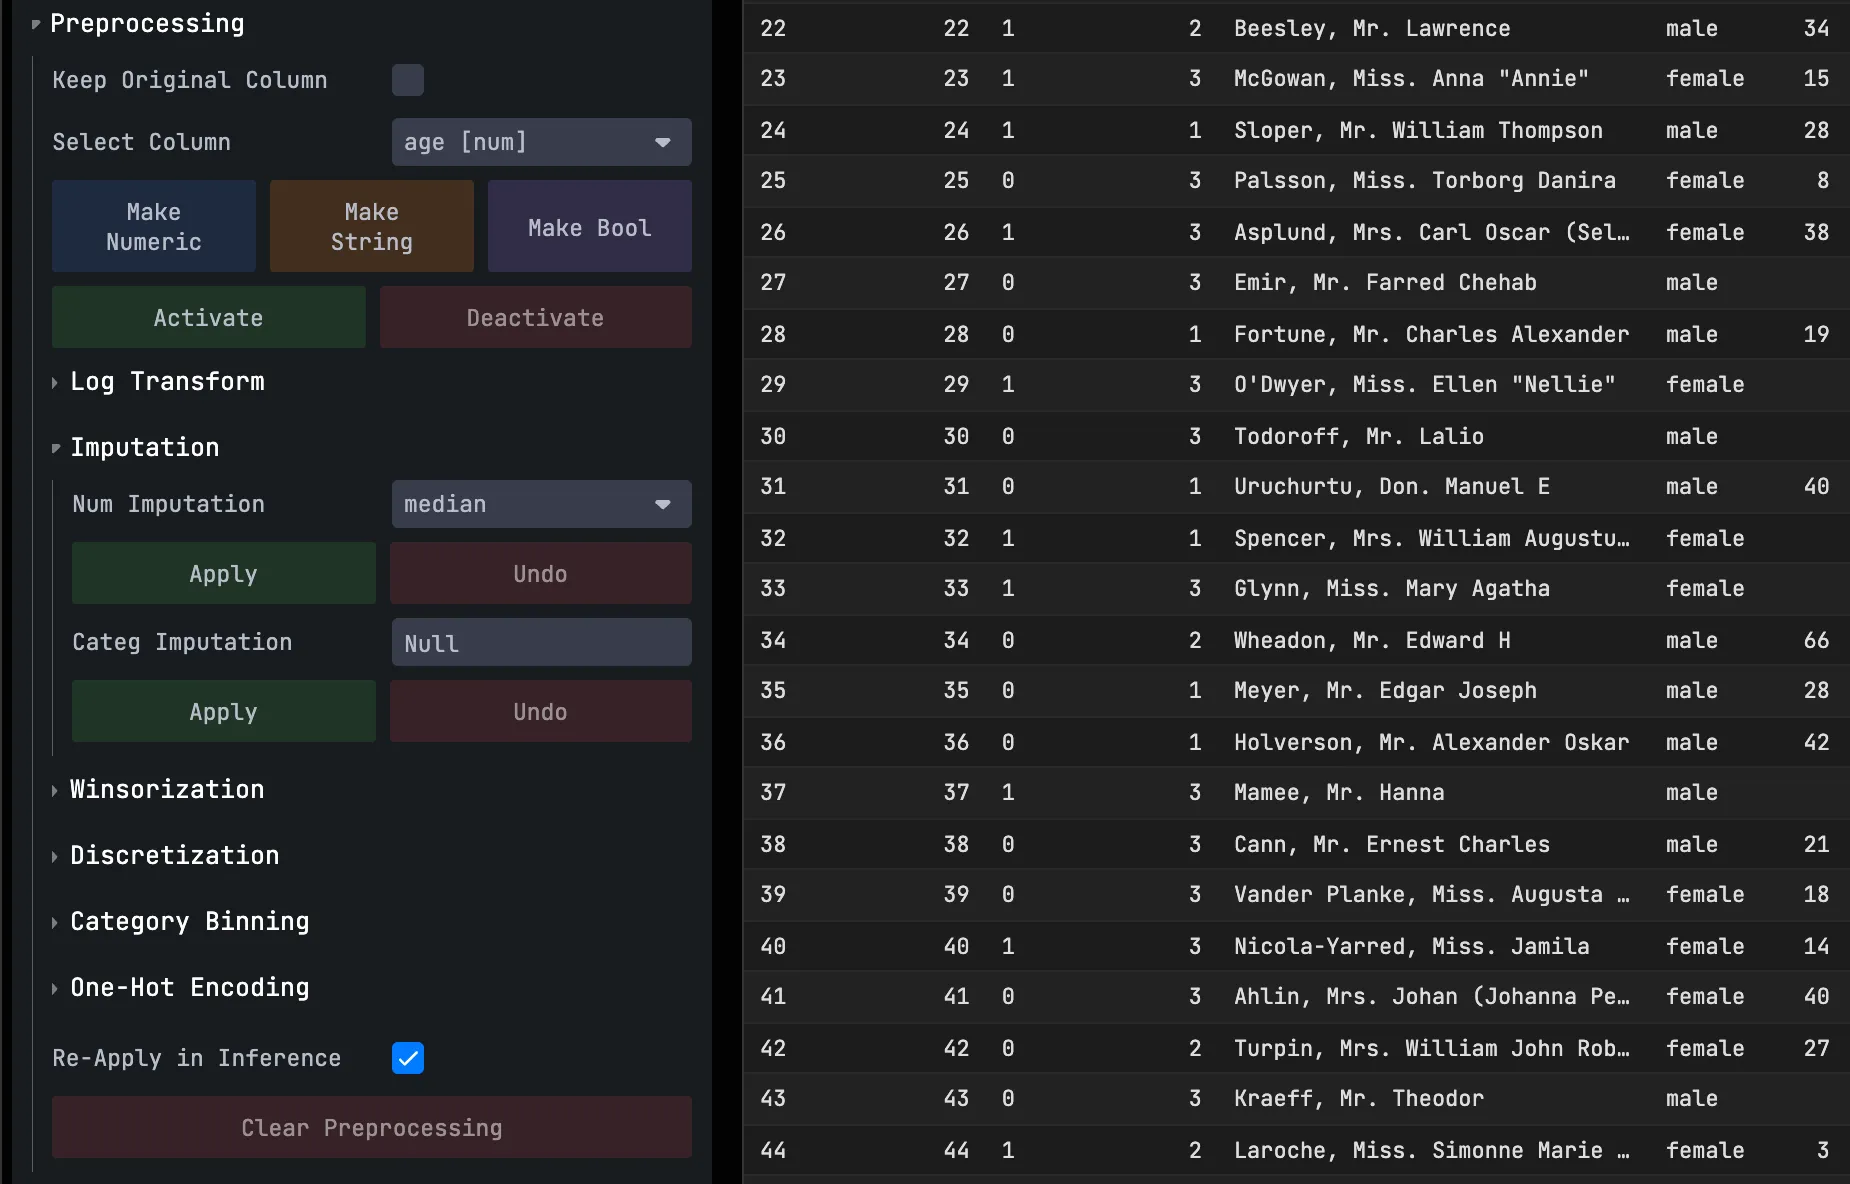
Le panneau Preprocessing rassemble les transformations qu'exigent les projections factorielles, le clustering ou l'apprentissage supervisé : changer le type d'une colonne ou l'exclure, passer au logarithme, remplir les vides (Imputation), plafonner les extrêmes (Winsorization), découper une variable numérique en quantiles (Discretization), regrouper les catégories rares (Category Binning), créer des indicatrices (One-Hot Encoding).
Elles s'appliquent dans cet ordre fixe, et leurs paramètres (la médiane qui remplit un vide, le centile qui plafonne un montant) sont calculés sur les seules lignes d'apprentissage. Les lignes de test n'influencent donc pas la préparation qui leur est appliquée. Keep Original Column garde la colonne source à côté de la colonne transformée ; Undo annule une étape, Clear Preprocessing les annule toutes.
Rejouer la même préparation sur de nouvelles données
Re-Apply in Inference conserve le réglage de chaque étape. Un modèle factoriel, de clustering ou supervisé déjà entraîné peut alors s'appliquer à un nouveau fichier : les mêmes médianes, les mêmes seuils et les mêmes regroupements lui sont appliqués, au lieu d'être recalculés sur lui.
Essayez-le sur vos données
Tout s’exécute dans votre navigateur : vos données ne le quittent pas.
Ouvrir TétrachoreMis à jour le 7 novembre 2026